导语
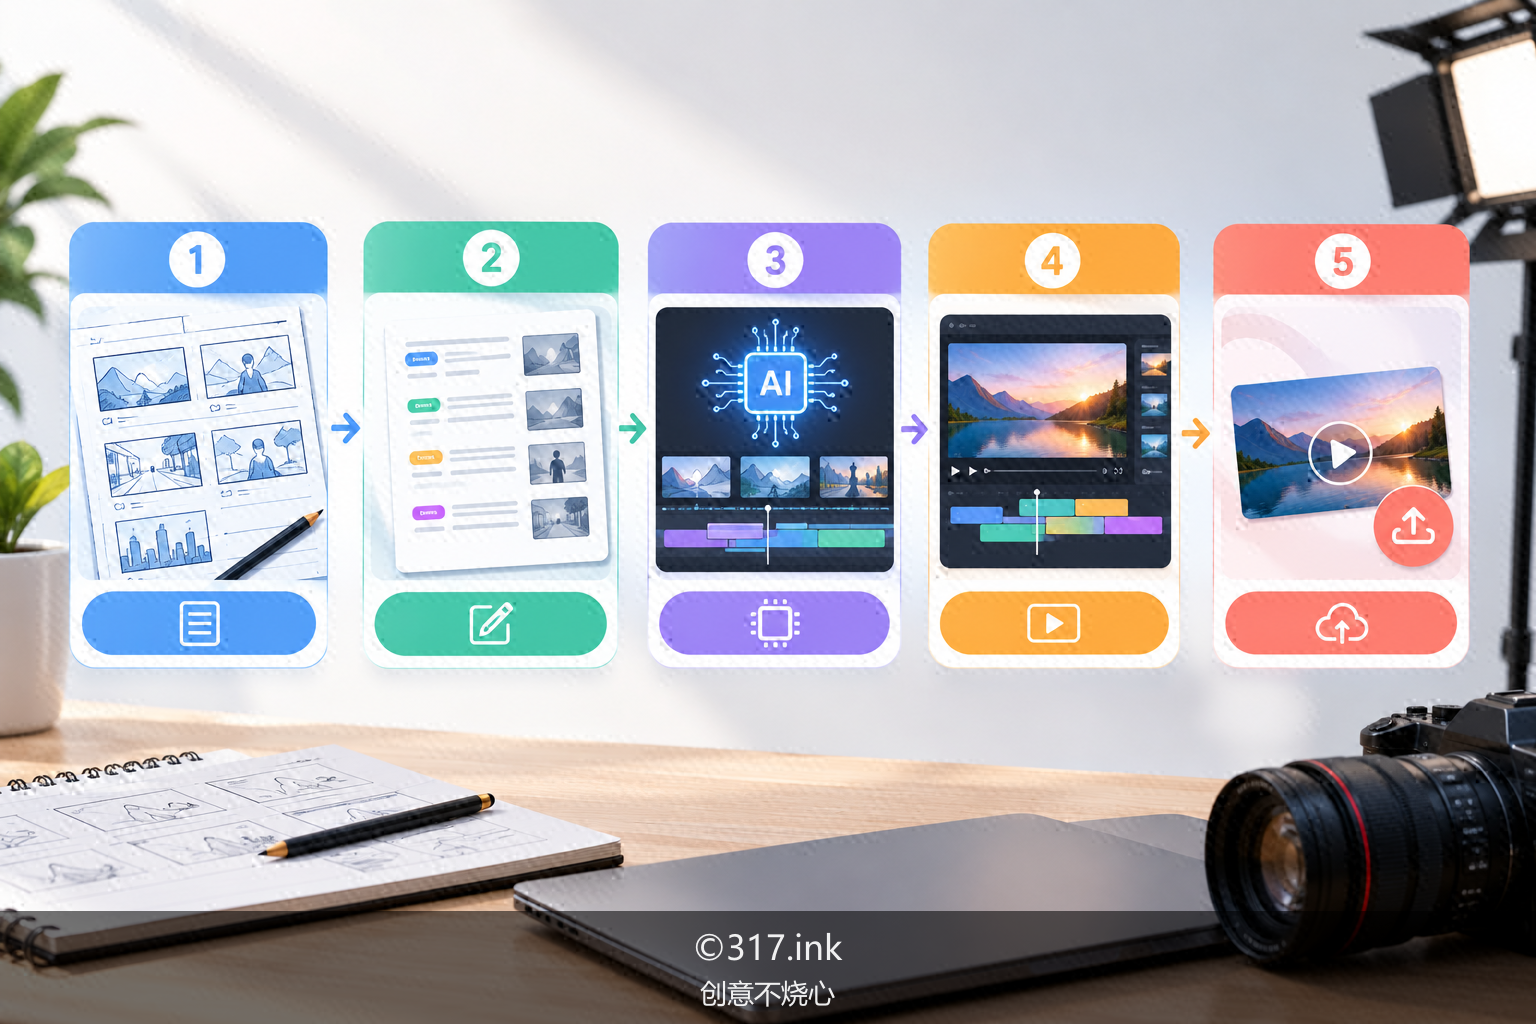
打开任何一个内容平台,相似的运镜、相似的旁白、相似的“AI感”封面扑面而来。工具越来越强,作品却越来越像。很多创作者陷入两难:不用AI,产能跟不上;用了AI,作品又像流水线上下来的。问题不在AI本身,而在于我们把“生成”当成了起点,却把“判断”丢在了终点。这篇拆解,想聊一套从分镜脚本到视频生成的可控流程,让AI参与创作,而不是替你做主。
一、先写“不能生成”的部分,再交给AI
很多人做视频的第一步是打开生成工具,输入提示词,等结果。这恰恰是同质化的源头——工具的默认审美会趋同。
更可控的做法是反着来:先用文字把“AI生成不了”的东西定下来。具体包括三样:情绪基调、叙事节奏、关键细节。
举例,你要做一条关于“深夜便利店”的短片。先别急着写提示词,而是在文档里写下:情绪是“疲惫里的片刻松弛”,节奏是“前30秒慢、中段一次小转折、结尾留白3秒”,关键细节是“收银台上一杯没盖盖子的关东煮”“店员打哈欠时手背上的创可贴”。
这三样东西决定了作品的“人味”,而它们恰恰是生成工具最不擅长的。先写下来,后面所有生成动作都围绕它们服务,作品才不会飘。
二、分镜脚本要写到“可执行”的颗粒度
分镜脚本不是文学描述,而是给生成工具的“施工图”。颗粒度不够,AI就会用它的默认模板填空。
一个可执行的分镜,每格至少包含:景别、主体动作、环境光线、镜头运动、时长。比如不要写“主角走进便利店”,而要写“中景,主角推门进入,头顶日光灯管有一根在闪,镜头固定,2秒”。
更进一步,给每一格标注“这一格必须保留什么”。比如“必须保留:关东煮冒热气的画面”。这样在生成结果不理想时,你知道该换提示词还是换工具,而不是整段推翻重来。
这套脚本还有一个好处:它是你后期剪辑的对照表。生成素材再多,你也不会迷失,因为每一格该长什么样,脚本里已经写死了。
三、把生成拆成“可控的小步”,而不是一次成片
一次性生成整条视频,是最容易翻车的做法,也是最容易同质化的做法。更稳的方式是把生成拆成小步:先出静帧,再图生视频,最后补局部。
第一步,用文生图把每个分镜的“关键帧”跑出来。这一步成本低、迭代快,重点看构图和光线对不对。不对就改提示词,别急着往下走。
第二步,选构图最接近的一帧做图生视频。这里有个细节:运动幅度调小。幅度越大,AI越容易“自由发挥”,画面越容易滑向它的默认风格。
第三步,局部补拍或补生成。比如手部动作、文字招牌、特定道具,这些AI容易出错的地方,单独生成再合成,比整段重跑更可控。
这套流程听起来慢,但返工少。你花在“筛选和修正”上的时间,远少于“整段重生成再碰运气”的时间。
四、用“反差清单”做最后一道质检
素材齐了,剪辑之前,给自己列一张反差清单,逐条过一遍:
- 这条片子里,有没有一个镜头是“只有我会这么拍”的?
- 旁白里有没有一句是“AI写不出来”的口语表达?
- 节奏上有没有一处“不按套路”的停顿或跳切?
- 声音层有没有真实环境音,而不是全程配乐铺满?
这张清单不追求全部打勾,但至少要中两条。一条都不中的作品,大概率会淹没在同质化内容里。反差不是刻意怪,而是把你作为具体的人的判断,留在作品里。
结尾行动引导
下次动手前,不妨先花二十分钟,把“情绪基调、节奏、关键细节”写在一张纸上,再打开生成工具。做完一条片子,用上面的反差清单过一遍,记下哪一步最耗时间、哪一步最容易跑偏。把这些记录攒起来,就是你自己的可控流程。工具会一直变,但你对自己作品的那份判断,才是别人复制不走的东西。